


Hai provato a far girare Llama 3.3 70B sul tuo laptop da 16 GB e il ventilatore ha iniziato a suonare come un aereo in decollo, per poi generare 2 token al secondo?
Benvenuto nel club. La memoria è il vero collo di bottiglia dell'inferenza locale: se i pesi del modello non stanno interamente in VRAM (o Unified Memory), finisci in CPU offload e la velocità crolla da 30–60 tok/s a 2–5 tok/s. In pratica: il modello "gira", ma non lo useresti mai per lavorare.
La soglia magica oggi è 64 GB di memoria utilizzabile. Sotto, sei confinato a modelli 7B–13B (ottimi per chat, insufficienti per coding serio, RAG complesso, reasoning). Sopra, si aprono i 30B–35B MoE (Qwen 3.6 35B, Gemma 4 26B) e, se arrivi a 128 GB, i 70B+ nativi (Llama 3.3, DeepSeek R1, Qwen 72B) con velocità finalmente usabili per produzione.
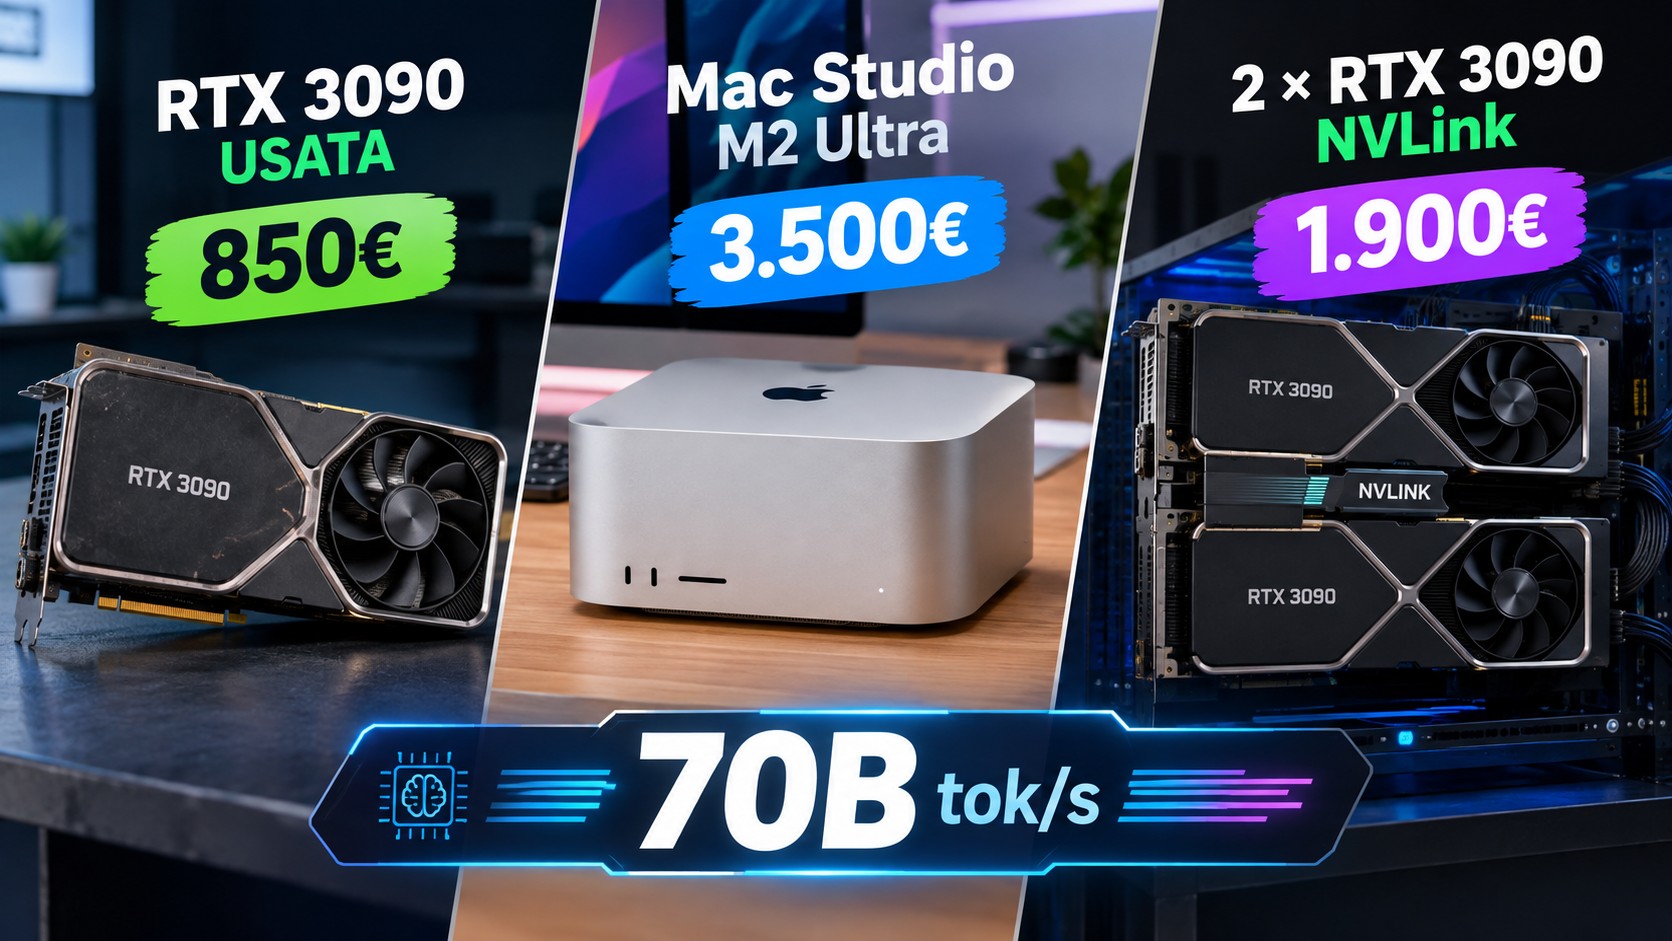
Il problema? Le schede consumer si fermano a 24 GB (RTX 3090/4090). Le workstation NVIDIA a 48 GB (A6000, 4090D) costano 3.000–3.500 € usate. L'unica via single-device sotto i 4.000 € per 70B+ fluido oggi è Apple Silicon con Unified Memory da 128 GB, Mac Studio M2 Ultra ricondizionato o MacBook Pro M3 Max.
Ho passato le ultime settimane a incrociare **benchmark reali** (bestgpuforllm.com, LLMCheck.net, WillItRun.ai, LocalLLM.in) con prezzi reali del mercato italiano dell'usato/ricondizionato (eBay, Subito, Wallapop, Back Market, TrenDevice, MediaWorld) per darti una rispostaesta alla domanda che tutti si fanno:
"Con il mio budget, qual è l'hardware che mi fa girare i modelli che voglio usare, non solo quelli che posso permettermi?"
Spoiler: non c'è un vincitore universale. C'è il vincitore per il tuo caso d'uso, il tuo budget e la tua tolleranza alla configurazione tecnica.
In questa guida troverai:
- 5 categorie di soluzioni a confronto (singola GPU usata, dual-GPU NVLink, workstation 48GB, Apple Silicon 128GB, next-gen Blackwell)
- Tabella "cosa gira dove" per modelli 8B, 32B, 70B, 120B MoE con tok/s stimati Q4_K_M
- Analisi TCO 3 anni (capex + elettricità + rivendibilità)
- Verdetti per 6 profili utente (hobbista, dev pro, serve 70B nativo, portabilità, produzione, top assoluto)
- Link diretti per cercare/acquistare oggi stesso su marketplace italiani
- Checklist "gotchas" pratici (mining check, NVLink setup, throttling MacBook, quantizzazione reale)
Nessun affiliate link, nessuna raccomandazione sponsorizzata. Solo dati, prezzi verificati a settembre 2026 e il verdetto che farei io al tuo posto.
📊 Rapporto Completo: Hardware per Inferenza LLM Locale (≥64GB RAM/VRAM) - Settembre 2026
🎯 Premessa e Metodologia
Obiettivo: Trovare la soluzione migliore per eseguire modelli LLM (7B–70B+) in locale con almeno 64 GB di memoria utilizzabile (VRAM o Unified Memory), ottimizzando il rapporto prestazioni/prezzo e includendo il mercato dell'usato/ricondizionato in Italia.
Fonti principali:
- Benchmark reali da bestgpuforllm.com (aggiornato set 2026)
- Database LLMCheck.net per Apple Silicon (248 benchmark)
- Analisi VRAM/token-speed da LocalLLM.in
- Guida compatibilità modelli da WillItRun.ai per Mac M2/M3
- Prezzi usati/ricondizionati da eBay Italia, Subito.it, Wallapop, Back Market, TrenDevice, MediaWorld Ricondizionati
Assunzioni chiave:
- Quantizzazione standard: Q4_K_M (4-bit) il miglior compromesso qualità/velocità
- Modelli target: 7B–13B (uso quotidiano), 30B–35B (coding/rag avanzato), 70B+ (massima qualità)
- La VRAM/Unified Memory è il collo di bottiglia duro: se il modello non ci sta, si va in CPU offload (2–5 tok/s vs 30–200+ tok/s)
- Bandwidth memoria = velocità token (tok/s). GDDR7 > GDDR6X > Unified Memory (800 GB/s M2 Ultra) > GDDR6
🖥️ Le 5 Categorie di Soluzioni a Confronto
| # | Soluzione | Memoria utile | Bandwidth | Prezzo nuovo (€) | Prezzo usato/ricond. (€) | Tok/s 8B Q4 | Tok/s 32B Q4 | Tok/s 70B Q4 | Note chiave |
|---|---|---|---|---|---|---|---|---|---|
| 1 | RTX 3090 24GB (usata) | 24 GB VRAM | 936 GB/s | — | 750–950 | ~55 | ~20 | ❌ (offload) | Best VRAM/€ — 24 GB a 1/3 prezzo 4090 |
| 2 | RTX 4090 24GB (usata) | 24 GB VRAM | 1008 GB/s | 2.200–2.500 | 1.800–2.300 | ~65 | ~22 | ❌ (offload) | Top consumer, garanzia residua, efficienza Ada |
| 3 | RTX 4090 D 48GB (usata/import) | 48 GB VRAM | 1008 GB/s | 3.800+ | 2.800–3.500 | ~65 | ~35 | ~12–15 | Unica consumer single-GPU per 70B Q4 nativo |
| 4 | Mac Studio M2 Ultra 128GB (ricond.) | 128 GB Unified | 800 GB/s | 3.999 | 3.000–4.000 | ~90–100 (MLX) | ~30–60 | ~12–16 | Unico single-box per 70B Q4 fluido |
| 5 | MacBook Pro M3 Max 128GB (usato) | 128 GB Unified | 400 GB/s | 2.499 | 2.200–2.800 | ~45–55 (MLX) | ~15–25 | ~8–12 | Portatile, stesso unified memory M2 Ultra ma metà bandwidth |
| 6 | RTX A6000 48GB (usata workstation) | 48 GB VRAM | 768 GB/s | 3.500+ | 2.500–3.500 | ~55 | ~35 | ~12–15 | ECC, driver enterprise, doppio slot, 300W |
| 7 | 2× RTX 3090 24GB (usate, NVLink) | 48 GB VRAM pool | 936 GB/s ×2 | — | 1.500–1.900 | ~110 | ~40 | ~20–25 | Richiede MB NVLink, PSU 1000W+, spazio, configurazione |
| 8 | RTX 5090 32GB (nuova, uscita 2025) | 32 GB VRAM | 1792 GB/s | ~2.200–2.500 | — | ~213 | ~61 | ~15–18 | Nuova generazione, GDDR7, costosa e rara usata |
Legenda: ✅ = gira nativo in VRAM/Unified; ⚠️ = gira con quantizzazione più spinta / context ridotto; ❌ = offload CPU (lento). Tok/s sono stime Q4_K_M, context 2–4K.
🔍 Analisi Dettagliata per Soluzione
1. RTX 3090 24GB usata — King of Value
- Prezzo reale Italia (eBay/Subito/Wallapop, set 2026): 750–950 € per schede gaming (MSI, ASUS, Gigabyte, ZOTAC). Founders Edition ~1.000–1.100 €.
- VRAM: 24 GB GDDR6X — soglia minima per 34B Q4 (serve ~20–21 GB reali con KV cache).
- Prestazioni: ~55 tok/s su 8B, ~20 tok/s su 32B/34B Q4_K_M. 70B non ci sta (serve offload → 2–5 tok/s).
- Pro: Miglior €/GB VRAM sul mercato; matura, driver stabili, enorme community, usata anche in dual-GPU.
- Contro: 350W TDP (serve PSU 750W+), niente garanzia, possibili ex-mining (verificare), no FP8/Transformer Engine, 24 GB limite duro per modelli >34B.
- Verdetto: Scelta #1 se budget ≤1.000 € e modelli target ≤34B. Per 70B serve seconda scheda.
2. RTX 4090 24GB usata: Best All-Rounder Consumer
- Prezzo reale Italia: 1.800–2.300 € (usato privato/pro, garanzia residua 1–2 anni). Nuove 2.200–2.500 €.
- VRAM: 24 GB GDDR6X: stesso limite 34B max nativo.
- Prestazioni: ~65 tok/s (8B), ~22 tok/s (34B). +15–20% vs 3090 grazie ad Ada Lovelace, clock più alti, cache L2 maggiore.
- Pro: Efficienza energetica migliore (450W ma più tok/W), encoder NVENC AV1, DLSS 3, garanzia spesso residua, rivendibilità alta.
- Contro: Prezzo ~2,5× 3090 usata per stessa VRAM. Non risolve il muro 70B.
- Verdetto: Scelta #1 se budget 1.800–2.300 €, vuoi garanzia, efficienza, e non servi 70B nativo.
3. RTX 4090 D 48GB (import Cina / OEM) — Unica Consumer Single-GPU per 70B
- Prezzo: 2.800–3.500 € usata/import (eBay venditori CN/DE). Non venduta retail EU.
- VRAM: 48 GB GDDR6X — fa girare 70B Q4_K_M nativo (~38–40 GB pesi + KV cache).
- Prestazioni: Simili 4090 24GB su modelli piccoli; su 70B ~12–15 tok/s (vs 2–5 offload).
- Pro: Unica scheda single-slot-logico consumer per 70B senza dual-GPU.
- Contro: Importazione (dogana, IVA, garanzia complessa), doppio slot fisico, 450–500W, driver OEM a volte limitati, rivendibilità incerta.
- Verdetto: Solo se 70B nativo è requisito hard e budget <3.500 €. Altrimenti Mac Studio M2 Ultra 128GB è più solido.
4. Mac Studio M2 Ultra 128GB (ricondizionato) — Best Single-Box per 70B+
- Prezzo ricondizionato Italia (Back Market, TrenDevice, MediaWorld, Subito): 3.000–4.000 € (grado "Ottimo"/"Come nuovo", garanzia 12 mesi). Nuovo 3.999 € (fuori produzione).
- Memoria: 128 GB Unified Memory (CPU+GPU+NE condivisi)
— zero copy, zero offload fino a 128 GB.
- Bandwidth: 800 GB/s (doppio M3 Max)
— chiave per tok/s su modelli grandi.
- Prestazioni reali (llama.cpp/MLX, Q4_K_M):
- 8B: 90–100 tok/s (MLX) / ~65 (llama.cpp)
- 30B–35B MoE: 30–60 tok/s
- 70B Q4_K_M: 12–16 tok/s (nativo, fluido per chat interattiva)
- 120B MoE (es. GPT-OSS, Mistral Small 4): 7–10 tok/s
- Pro: Unica soluzione single-device <4.000 € che fa 70B+ nativo fluidamente; macOS + MLX/llama.cpp/Ollama/LM Studio out-of-the-box; consumo ~200W max; silenzioso; rivendibilità alta; garanzia ricondizionati 12 mesi.
- Contro: Ecosistema CUDA assente (no PyTorch CUDA, no FlashAttention-2, no vLLM/TGI nativi); MLX/Metal meno ottimizzati di CUDA per alcuni kernel; bandwidth 800 GB/s < H100/A100 (1.5–2 TB/s); non aggiornabile.
- Verdetto: Scelta #1 se serve 70B+ nativo, budget 3.000–4.000 €, vuoi "apri e funziona" senza configurare driver/CUDA/Python env. Migliore TCO per privacy/latenza se usi >5h/giorno (break-even vs API cloud ~36 mesi).
5. MacBook Pro 16" M3 Max 128GB (usato) — Portatile con 128 GB Unified
- Prezzo usato Italia: 2.200–2.800 € (fine 2023/inizio 2024, garanzia AppleCare spesso residua).
- Memoria: 128 GB Unified — stessa capacità M2 Ultra.
- Bandwidth: 400 GB/s (metà M2 Ultra)
— collo di bottiglia su modelli grandi.
- Prestazioni reali:
- 8B: ~45–55 tok/s (MLX)
- 30B–35B: ~15–25 tok/s
- 70B Q4_K_M: ~8–12 tok/s (usabile ma lento vs M2 Ultra 12–16)
- Pro: Portabilità; stesso unified memory 128 GB; schermo XDR; batteria per inferenza breve; rivendibilità altissima.
- Contro: Bandwidth dimezzato → tok/s 30–50% inferiori su modelli >13B; throttling termico sotto carico sostenuto; non espandibile; prezzo usato vicino a Mac Studio M2 Ultra ricond. ma prestazioni inferiori.
- Verdetto: Solo se la portabilità è requisito hard. Altrimenti Mac Studio M2 Ultra 128GB ricond. costa uguale/meno e va 2× più veloce su 70B.
6. NVIDIA RTX A6000 48GB (usata workstation): Pro/Enterprise Single-GPU
- Prezzo usato Europa (eBay.de, eBay.it, rivenditori WS): 2.500–3.500 € (ex-lease, garanzia 6–12 mesi venditori pro).
- VRAM: 48 GB GDDR6 con ECC — 70B Q4 nativo come 4090 D.
- Bandwidth: 768 GB/s (inferiore a 4090/3090).
- Prestazioni: ~55 tok/s (8B), ~35 tok/s (34B), ~12–15 tok/s (70B).
- Pro: ECC memory (affidabilità 24/7), driver enterprise/stabili, certificata per stack NVIDIA AI (NGC, RAPIDS, Triton), doppio slot ma blower (ottimo per multi-GPU rack), 300W TDP (più gestibile).
- Contro: Prezzo 2–3× RTX 3090 usata per stessa VRAM; bandwidth inferiore a 3090/4090; niente Tensor Core 4ª gen (no FP8, no Transformer Engine); driver consumer (GeForce Experience) non supportati; rivendibilità nicchia.
- Verdetto: Solo per workloads production/enterprise che richiedono ECC, driver LTS, supporto NVIDIA AI Enterprise. Per hobbisti/sviluppatori: 2× RTX 3090 o Mac Studio M2 Ultra sono meglio.
7. Dual RTX 3090 24GB (NVLink): Best Raw Performance/€ per 70B
- Costo totale (2× usate + cavo NVLink + PSU 1000W+ MB compatibile): 1.700–2.200 €.
- VRAM pool: 48 GB (NVLink 112 GB/s bidirezionale)
— 70B Q4 nativo con llama.cpp --tensor-split / exllama_v2 / vLLM tensor parallel.
- Prestazioni: ~110 tok/s (8B), ~40 tok/s (34B), ~20–25 tok/s (70B) — più veloce di Mac Studio M2 Ultra e 4090 D 48GB.
- Pro: Miglior tok/s/€ per 70B; flessibilità (puoi usare 1 sola scheda per modelli piccoli); rivendibilità singola scheda facile.
- Contro: Complessità alta: MB con 2× PCIe x16 elettrico (x8/x8 o x16/x4), PSU 1000–1200W, cavo NVLink (50–80 €), case grande, raffreddamento, driver Linux/Windows per tensor parallel, debugging memory imbalance. Consumo 700W+ sotto carico.
- Verdetto: Scelta #1 per performance pure/€ se sai configurare Linux + CUDA + tensor parallel. Non "plug & play".
8. RTX 5090 32GB (nuova, Blackwell): Future-Proof Flagship
- Prezzo: ~2.200–2.500 € MSRP (disponibilità limitata set 2026).
- VRAM: 32 GB GDDR7 — fa 34B Q4 comodo, 70B Q4 stretto (~38 GB necessari → offload parziale o Q3_K_M).
- Bandwidth: 1.792 GB/s (GDDR7)
— massima consumer.
- Prestazioni: 213 tok/s (8B), 61 tok/s (32B), ~15–18 tok/s (70B Q3/Q4 offload parziale).
- Pro: Architettura Blackwell, FP8, Transformer Engine, GDDR7, 32 GB VRAM, miglior tok/s assoluto consumer.
- Contro: Costosa, rara, 575W TDP (connettore 12VHPWR), nuova (bug driver iniziali), prezzo usato non ancora formato.
- Verdetto: Aspetta 6–12 mesi per prezzo usato stabile. Oggi non batte Mac Studio M2 Ultra 128GB ricond. per 70B nativo fluido a parità di budget.
📈 Tabella Sintetica: Cosa Gira Dove (Q4_K_M, context 4K)
| Modello (param) | VRAM/UM richiesta | RTX 3090/4090 24GB | RTX 4090D/A6000 48GB | 2×3090 NVLink | Mac Studio M2 Ultra 128GB | MacBook Pro M3 Max 128GB | RTX 5090 32GB |
|---|---|---|---|---|---|---|---|
| Llama 3.1 8B | ~6 GB | ✅ 55–65 tok/s | ✅ 55–65 | ✅ 110 | ✅ 90–100 | ✅ 45–55 | ✅ 213 |
| Qwen 32B / 34B | ~20 GB | ✅ 20–22 tok/s | ✅ 35 | ✅ 40 | ✅ 30–60 | ✅ 15–25 | ✅ 61 |
| Llama 3.3 70B | ~38–40 GB | ❌ offload 2–5 | ✅ 12–15 | ✅ 20–25 | ✅ 12–16 | ⚠️ 8–12 | ⚠️ 15–18* |
| Qwen 72B / 119B MoE | ~50–60 GB | ❌ | ❌ | ⚠️ 8–10 | ✅ 7–10 | ❌ | ❌ |
| DeepSeek R1 70B | ~38–40 GB | ❌ | ✅ 12–15 | ✅ 20–25 | ✅ 12–16 | ⚠️ 8–12 | ⚠️ 15–18* |
*RTX 5090 32GB: 70B Q4 richiede offload parziale o Q3_K_M (qualità inferiore). Tok/s stimati.
💰 Analisi Costo Totale di Proprietà (TCO 3 anni)
| Soluzione | Capex (€) | Consumo annuo (€, 4h/g @ 0,30 €/kWh) | Totale 3 anni (€) | Tok/s 70B Q4 | €/tok/s (70B) |
|---|---|---|---|---|---|
| RTX 3090 usata (singola) | 850 | 180 | 1.390 | N/A (offload) | — |
| 2× RTX 3090 usate + NVLink | 1.900 | 450 | 3.250 | ~22 | 148 |
| RTX 4090 usata | 2.050 | 230 | 2.740 | N/A | — |
| RTX 4090D 48GB import | 3.150 | 230 | 3.840 | ~13 | 295 |
| Mac Studio M2 Ultra 128GB ricond. | 3.500 | 100 | 3.800 | ~14 | 271 |
| MacBook Pro M3 Max 128GB usato | 2.500 | 50 | 2.650 | ~10 | 265 |
| RTX A6000 48GB usata | 3.000 | 155 | 3.465 | ~13 | 266 |
| RTX 5090 nuova | 2.350 | 300 | 3.250 | ~16* | 203 |
*Con offload parziale / Q3. Mac Studio vince su TCO se valuti "plug&play + zero config + garanzia + rivendibilità + consumo basso". Dual 3090 vince su €/tok/s puro ma richiede competenze sysadmin.
🎯 Raccomandazioni per Profilo Utente
| Profilo | Budget | Requisito chiave | Scelta Consigliata | Alternativa |
|---|---|---|---|---|
| Sviluppatore hobbista / budget ≤1.000 € | ≤1.000 € | Modelli ≤34B, imparare CUDA/llama.cpp | RTX 3090 24GB usata (800 €) | RTX 3060 12GB usata (250 €) solo 7B–13B |
| Sviluppatore pro / budget 1.800–2.300 € | 1.800–2.300 € | 34B nativo, garanzia, efficienza, rivendibilità | RTX 4090 24GB usata (2.000 €) | RTX 4070 Ti Super 16GB nuova (800 €) solo ≤13B |
| Serve 70B nativo fluido / budget 3.000–4.000 € | 3.000–4.000 € | 70B Q4 nativo, zero config, macOS, privacy | Mac Studio M2 Ultra 128GB ricondizionato (3.500 €) | 2× RTX 3090 NVLink (1.900 €) se sai sysadmin Linux |
| Serve 70B nativo + portabilità / budget 2.500–3.000 € | 2.500–3.000 € | 70B nativo + laptop | MacBook Pro M3 Max 128GB usato (2.500 €) | Mac Studio M2 Ultra ricond. (meglio perf, niente portabilità) |
| Team/Produzione / budget 3.000–5.000 € | 3.000–5.000 € | ECC, driver LTS, multi-user, vLLM/TGI, SLA | RTX A6000 48GB usata (3.000 €) ×2 o H100 80GB cloud | Mac Studio M2 Ultra ×2 (cluster MLX) |
| Massime prestazioni assolute / budget >4.000 € | >4.000 € | Tok/s massimi, future-proof | RTX 5090 32GB nuova (2.400 €) ×2 o B200/H100 usati | Mac Studio M3 Ultra 256GB (6.999 € nuovo) |
🔗 Link di Riferimento Diretti (per approfondire/acquistare)
NVIDIA Consumer (usato Italia)
- RTX 3090 24GB usate: eBay.it | Subito.it | Wallapop
- RTX 4090 24GB usate: eBay.it | Subito.it | Wallapop
- RTX 4090 D 48GB (import): eBay.it venditori CN/DE
NVIDIA Workstation (usato EU)
Apple Silicon Ricondizionato Italia (garanzia 12 mesi)
- Mac Studio M2 Ultra 128GB: Back Market | TrenDevice | MediaWorld Ricondizionati | Subito.it
- MacBook Pro 16 M3 Max 128GB: Back Market | TrenDevice | Subito.it
Benchmark & Calcolatori
- GPU Comparison Table (tok/s, VRAM, prezzo): https://bestgpuforllm.com/compare/
- Apple Silicon Benchmarks (248 data points): https://llmcheck.net/benchmarks
- VRAM Calculator (modello × quant × context): https://localllm.in/vram-calculator
- Modelli compatibili per Mac specifico: https://willitrunai.com/macs/
- Guida GPU NVIDIA per Deep Learning (dev74): https://www.dev74.com/blog-notizie/le-migliori-gpu-nvidia-per-deep-learning-e-inferenza-locale-prestazioni-memoria-e-prezzo
⚠️ Avvertenze e "Gotchas" Pratici
- VRAM ≠ Unified Memory per bandwidth: 128 GB Unified @ 400–800 GB/s ≠ 48 GB VRAM @ 768–1008 GB/s per tok/s puro. Ma Unified vince su capacità totale e assenza offload.
- Usato GPU: verifica mining. Chiedi foto PCB, seriale, test FurMark/3DMark, stress test VRAM (memtestG80). Evita venditori "0 feedback" su eBay.
- Dual 3090 NVLink: Serve motherboard con 2× PCIe x16 elettrico (es. X299, TRX40, WRX80, Z690/Z790 con bifurcation), cavo NVLink 3-slot/4-slot corretto, PSU 1000W+ Platinum. Su Windows tensor parallel limitato; Linux + vLLM/llama.cpp migliore.
- Mac Studio M2 Ultra ricondizionato: Controlla che sia M2 Ultra (non M2 Max), 128 GB (non 64/96), SSD 1 TB+ (modelli base 512 GB si riempiono veloce con modelli). Grado "Ottimo" o "Come nuovo" + garanzia 12 mesi venditore pro.
- Quantizzazione: Q4_K_M è standard. Q3_K_M / Q2_K risparmiano VRAM ma degradano qualità (specie reasoning/coding). Q8_0 serve 2× VRAM per +10–15% qualità.
- Software stack:
- NVIDIA: llama.cpp (CPU/GPU offload), exllama_v2 (solo GPU, più veloce), vLLM (serving multi-user, tensor parallel), Ollama (facile, usa llama.cpp).
- Apple: MLX (più veloce nativo), llama.cpp (Metal), Ollama/LM Studio (GUI facili).
- Alimentazione: RTX 3090/4090 = 350–450W picco. 2×3090 = 700W+ → PSU 1000–1200W ATX 3.0/3.1 (12VHPWR nativo). Mac Studio = 370W max (incluso monitor).
- Rumore: RTX 3090/4090 custom = ventole udibili sotto carico. FE = blower (più rumorose). Mac Studio = silenzioso (ventola unica, curve conservative). A6000 = blower workstation (rumorosa in camera da letto).
📋 Checklist Decisionale Rapida
| Domanda | Se SÌ → Vai a |
|---|---|
| Budget ≤ 1.000 €? | RTX 3090 24GB usata |
| Budget 1.800–2.300 €, serve 34B nativo, garanzia? | RTX 4090 24GB usata |
| Serve 70B Q4 nativo fluido budget 3.000–4.000 €, zero config? | Mac Studio M2 Ultra 128GB ricondizionato |
| Serve 70B nativo + portabilità budget 2.500–3.000 €? | MacBook Pro M3 Max 128GB usato |
| Sai configurare Linux + NVLink + tensor parallel, vuoi max tok/s/€ per 70B? | 2× RTX 3090 24GB usate + NVLink |
| Produzione/Enterprise: ECC, driver LTS, vLLM/TGI, SLA? | RTX A6000 48GB usata (o H100 cloud) |
| Vuoi il top assoluto consumer 2025+, budget >2.500 €, aspetti disponibilità? | RTX 5090 32GB nuova |
🏁 Conclusione
Per "almeno 64 GB memoria utile + budget consapevole + inferenza locale seria":
| Scenario | Vincitore |
|---|---|
| Best Value Assoluto (≤34B) | RTX 3090 24GB usata ~850 € — imbattibile €/GB VRAM |
| Best All-Rounder Consumer (≤34B, garanzia) | RTX 4090 24GB usata ~2.000 € |
| Best Single-Box per 70B+ nativo (<4.000 €) | Mac Studio M2 Ultra 128GB ricondizionato ~3.500 € — unico che fa 70B Q4 a 12–16 tok/s out-of-the-box, garanzia 12 mesi, 200W, silenzioso |
| Best Raw Performance/€ per 70B (se sysadmin) | 2× RTX 3090 24GB NVLink ~1.900 € — 20–25 tok/s su 70B, ma complessità alta |
| Best Portatile 70B nativo | MacBook Pro M3 Max 128GB usato ~2.500 € — metà speed M2 Ultra, ma sta in zaino |
Il mio consiglio personale: Se il budget lo permette (3.000–4.000 €) e non hai esigenze CUDA-specifiche (training, FlashAttention-2, vLLM multi-GPU), Mac Studio M2 Ultra 128GB ricondizionato è la scelta più razionale oggi. Ti dà 128 GB unified memory, 70B+ nativo, ecosystem macOS/MLX/Ollama maturo, garanzia, consumi bassi, e rivendibilità forte. È l'unico "appliance AI" pronto all'uso in quella fascia.
Se invece il budget è ≤1.000 € o vuoi imparare lo stack CUDA/Linux: RTX 3090 24GB usata resta il re indiscusso del value.
Rapporto generato il 19 settembre 2026 con TuaGPT (Nemotron 3 Ultra). Prezzi e disponibilità usati volatili, verifica sempre annunci attuali prima di acquistare. Benchmark tok/s sono stime Q4_K_M context 2–4K; prestazioni reali variano per engine (llama.cpp vs MLX vs exllama_v2 vs vLLM), prompt length, batch size, OS/driver.
Commenti su «Hardware per LLM Locali 2026: 64GB+ VRAM/RAM, Usato vs Nuovo, Benchmark Reali»
Non ci sono ancora commenti. Scrivi il primo!
Lascia un commento
Non è necessario accedere. Commenti e risposte saranno pubblicati dopo approvazione. Puoi anche usare «Rispondi» sotto un commento già approvato.