


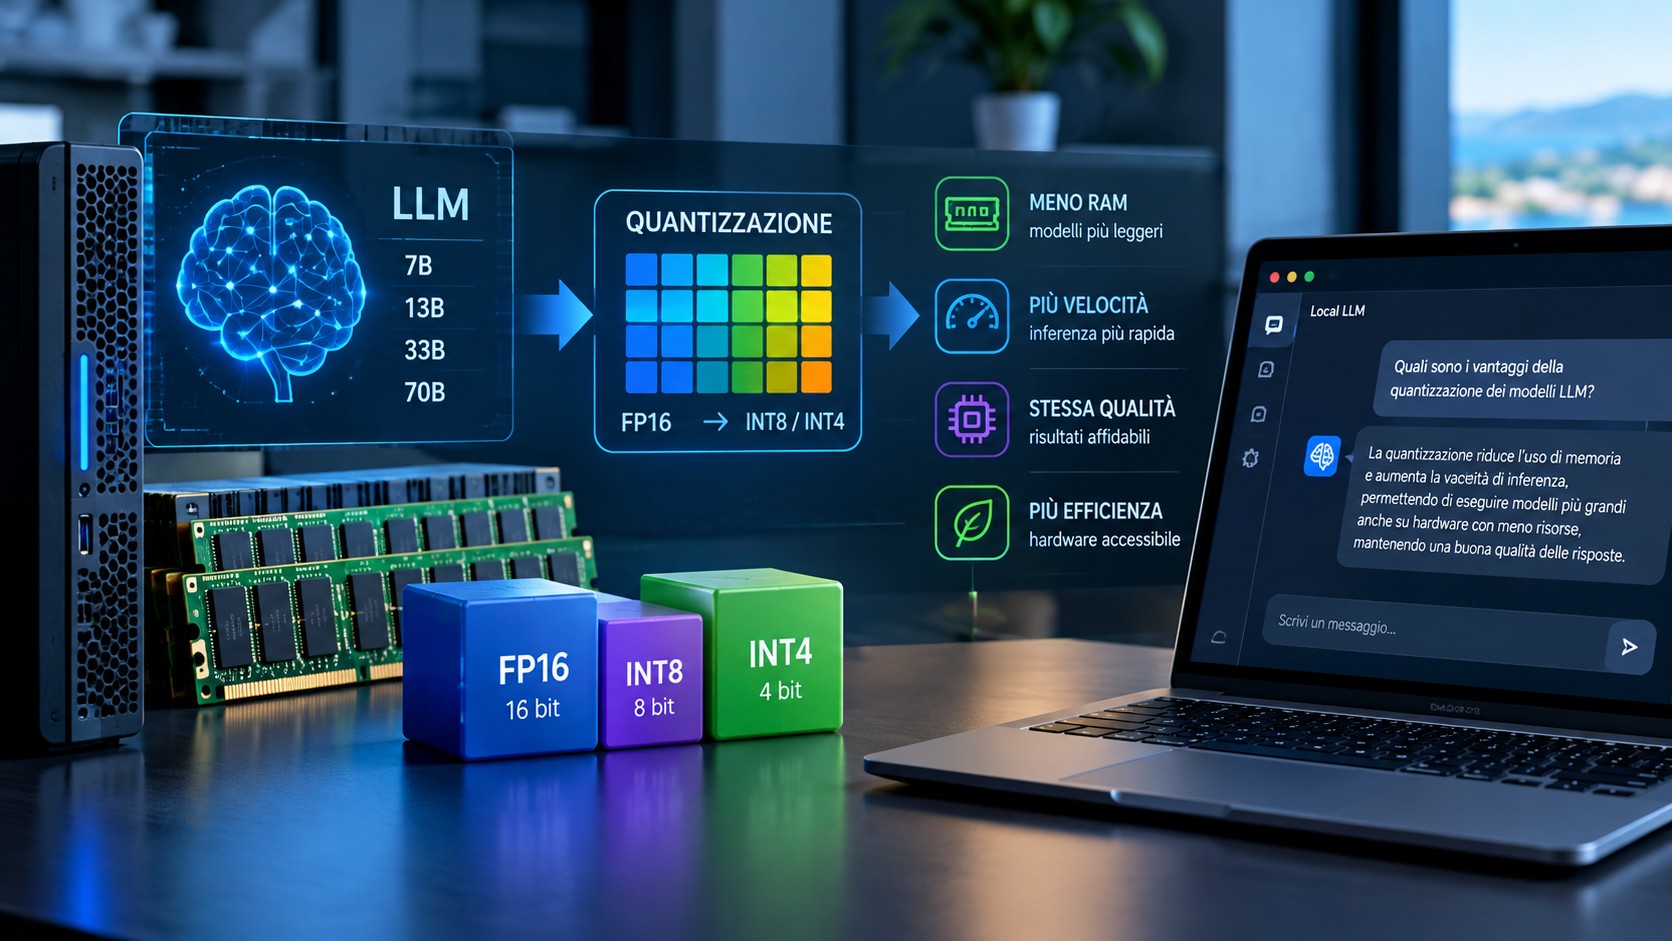
Due modelli possono chiamarsi entrambi «4B» o «7B» e chiedere quantità di memoria molto diverse. Uno entra in un PC con 16 GB di RAM, l'altro no. Il file scaricato può pesare 4 GB e, una volta caricato, il programma può arrivare a 8 GB. In altri casi file e memoria restano quasi uguali. Dipende da come sono scritti i numeri del modello, da quale programma li esegue e da quanto contesto mantieni aperto nella conversazione.
Cosa significa il numero 4b nel nome
Un grande modello di linguaggio (LLM, Large Language Model) è, in pratica, una tabella enorme di numeri. Quei numeri si chiamano parametri: sono i pesi con cui il programma trasforma il testo che gli mandi nel testo che ti risponde. Più parametri ci sono, più il modello può essere capace, e più memoria serve per tenerli pronti.
La «B» nel nome sta per billion, miliardo in inglese. spark-x2.5-4b indica circa 4 miliardi di parametri. llama-3.1-8b ne indica circa 8. Quel numero dice quanto è grande il modello. Non dice da solo quanti gigabyte occuperà sul disco, né quanta RAM servirà per usarlo.
Nel nome del file compaiono altre sigle, e non sono tutte la stessa cosa:
- GGUF è il tipo di file, la «scatola» usata da LM Studio, Ollama e llama.cpp. Dentro può esserci un modello quantizzato oppure una copia FP16.
- Safetensors è un altro tipo di file, più comune nei download originali, prima della conversione in GGUF.
- Q4, Q5, Q8 dicono quanto sono accorciati i numeri (quantizzazione).
- F16 o FP16, e a volte BF16, dicono che ogni numero occupa 2 byte, senza quella riduzione.
Dai parametri ai gigabyte
Ogni parametro è un numero. La memoria che occupa dipende da quanti byte usi per scriverlo. Un byte è l'unità piccola con cui il computer conta i file: 1 GB è circa un miliardo di byte.
Il conto di base, solo per i pesi, è questo: miliardi di parametri per byte usati da ciascun parametro.
| Come è salvato il numero | Byte per parametro | Esempio su 4 miliardi | Esempio su 8 miliardi |
|---|---|---|---|
| Q4 (quantizzazione a 4 bit) | circa 0,5 (un po' di più nei file K) | circa 2,5 GB | da 4,5 a 5 GB |
| Q8 (8 bit) | circa 1 | circa 4 GB | circa 8 GB |
| FP16 o BF16 (16 bit) | 2 | circa 8 GB | circa 16 GB |
| FP32 (32 bit) | 4 | circa 16 GB | circa 32 GB |
I bit sono solo la lunghezza del numero: 16 bit sono 2 byte, 32 bit sono 4 byte. FP16 e BF16 occupano lo stesso spazio. BF16 è un altro modo di scrivere i decimali, frequente nei modelli recenti, non una compressione.
Un 4B non è la metà di un 7B: quattro miliardi sono poco più della metà di sette miliardi. Per passare da una riga all'altra conviene rifare il conto, non dividere a occhio la tabella di un altro modello. Un 13B, a parità di formato, pesa poco più di una volta e mezza rispetto a un 8B.
Windows a volte mostra i gigabyte un filo più bassi del numero tondo del download, perché conta 1024 al posto di 1000. Per decidere se un modello entra nel PC, quella differenza non cambia la scelta.
Quantizzazione: stesso modello, file più corto
La quantizzazione accorcia i pesi: al posto di un numero molto preciso ne salva uno più corto, a 8 bit, a 5, a 4. I miliardi di parametri restano gli stessi. Cambia solo quanto spazio occupa ciascuno. In chat quotidiana la perdita si nota poco, soprattutto con le varianti intermedie. Con una compressione molto spinta (Q3, Q2) la differenza si sente di più.
Le sigle che vedi dopo Q4 o Q5, per esempio Q4_K_M o Q5_K_M, indicano il metodo usato per accorciare i numeri. La «K» conserva, accanto ai pesi, dei fattori di scala per piccoli gruppi di valori: il file è un po' più grande di un Q4 semplice (Q4_0) e in genere risponde un po' meglio. L'ultima lettera dice quanto è generosa la miscela: S più compatta, M media, L un po' più fedele e un po' più pesante. Per la RAM conta soprattutto il numero dopo la Q. Tra S, M e L la differenza, su un 8B, è di solito inferiore a 1 GB.
Un Q5 sta tra Q4 e Q8. Per un modello da 8 miliardi il file pesa circa 6 GB.
Un modello non quantizzato, in questo contesto, è un FP16, un BF16 o un FP32. È la copia più fedele ai pesi originali, e anche la più pesante. Su un PC di casa la scelta abituale è un GGUF Q4 o Q5. Q8 è un buon compromesso se la memoria avanza. FP16 ha senso se RAM o VRAM sono abbondanti.
Perché il file e la RAM a volte coincidono, a volte no
La dimensione del file dice quanto spazio serve sul disco. La RAM è ciò che il motore di inferenza tiene pronto mentre il modello risponde. Con i file GGUF aperti da LM Studio o da Ollama, i pesi in memoria restano in genere vicini alla dimensione del file: il programma non «decomprime» da solo un Q4 fino a farlo diventare un FP16. Il raddoppio non è una regola di tutti i modelli. Compare in situazioni precise.
Il caso del doppio: da 2 byte a 4 byte
Prendi un 4B non quantizzato, salvato in FP16. Il file sta intorno agli 8 GB, perché 4 miliardi per 2 byte fanno 8 miliardi di byte. Se il programma che lo esegue tiene quei pesi in FP32, passa a 4 byte per parametro e la sola tabella dei pesi va verso i 16 GB. Il file non è cambiato: è cambiato il formato in memoria. È il caso più pulito di «la RAM è circa il doppio del disco», e riguarda i modelli non quantizzati, non i Q4.
File quantizzato e memoria più alta del file
Un 4B in Q4 sta intorno ai 2,5 GB su disco. Se a regime il processo ne mostra 4 o 5, di solito non ha ritrasformato i pesi in FP16. Sta sommando altre cose:
- la finestra di contesto che il motore riserva tutta all'avvio, anche se la chat è ancora corta (ne parliamo sotto);
- un picco temporaneo durante il caricamento, quando per un momento esistono due copie;
- il programma stesso, il vocabolario che spezza le parole in pezzi (il tokenizer, di solito poche decine di MB) e gli spazi temporanei usati per il calcolo (i buffer di lavoro).
Il vocabolario non spiega un raddoppio: è piccolo. Su un 4B anche una finestra da 8192 token aggiunge di solito meno di 1 GB. I gigabyte in più, oltre i pesi, arrivano con finestre molto lunghe o con modelli più grandi.
Due contatori diversi
RAM di sistema e memoria della scheda video (VRAM) sono due posti distinti. Se una parte del modello sta nel processore e una parte nella GPU, vanno sommate. Non sono due letture dello stesso dato. Subito dopo il caricamento può restare per poco una copia in più: a regime, conta dove il motore dice di aver messo i pesi.
Quanta memoria chiede solo il modello
I numeri qui sotto sono i soli pesi, in formato GGUF, quando il motore li tiene nel formato del file. Non includono Windows, il browser, TuaGPT, né la finestra di contesto. I Q8 sono un filo sopra il conto tondo della tabella precedente, perché il file salva anche dei fattori di scala accanto ai pesi.
| Parametri | Q4_K_M | Q8 | FP16 |
|---|---|---|---|
| circa 4 miliardi | circa 2,5 GB | circa 4,3 GB | circa 8 GB |
| circa 8 miliardi | da 4,5 a 5 GB | circa 8,5 GB | circa 16 GB |
| circa 14 miliardi | da 8 a 9 GB | circa 15 GB | circa 28 GB |
| circa 32 miliardi | da 18 a 20 GB | circa 34 GB | circa 64 GB |
| circa 70 miliardi | circa 42 GB | circa 75 GB | circa 140 GB |
Su un PC con 16 GB di RAM, Windows e i programmi aperti ne usano spesso 4 o 6. Restano circa 10 GB per il modello e per il contesto, se tutto gira sul processore. Un 8B in Q4 ci sta, con una finestra di contesto moderata. Un 8B in FP16 chiede circa 16 GB solo di pesi: una scheda da 16 GB di VRAM è già al limite, perché alla tabella dei pesi va aggiunta la finestra di contesto. La misura comoda, per quel formato, è una scheda da 24 GB. Spostare il modello sulla GPU non lo rimpicciolisce. Se ci sta per intero, i pesi passano nella memoria della scheda e la RAM di sistema resta libera per il sistema operativo e per il software lanciato.
Con 32 GB di RAM hai margine per un 8B in Q5 o Q8, oppure per un 14B in Q4, più una chat lunga. Un 70B anche in Q4 chiede circa 42 GB di soli pesi, più il contesto: 32 GB di RAM, senza una scheda video capiente su cui spostarne una parte, di solito non bastano.
Il contesto: memoria in più, oltre al file
I pesi sono la tabella fissa. Accanto, il motore tiene una memoria di lavoro della conversazione già letta, la KV cache (da key e value, le due tracce che il modello conserva per non rileggere da zero ogni parola precedente). Più testo entra nella stessa richiesta, più questa memoria cresce.
Quel testo si misura in token. Un token è un pezzo di parola, non una parola intera. In italiano, mille token sono all'incirca 700 parole. Una frase breve sta spesso tra 15 e 40 token. Un documento di parecchie pagine arriva alle migliaia.
In LM Studio e in Ollama imposti la lunghezza massima di questa finestra (context length). Valori tipici: 4096, 8192, 16384, 32768. Attenzione al dettaglio che fa la differenza in Gestione attività: molti motori riservano subito la memoria per l'intera finestra, anche se hai scritto due righe. Impostare 32768 «tanto per» occupa lo spazio di una chat lunghissima fin dal primo messaggio.
Quanto aggiunge, in pratica, dipende dalla finestra e da come è costruito il modello, in particolare da quanti strati ha. Come ordine di grandezza, su un modello intorno agli 8 miliardi, con la cache non compressa:
- finestra da 4096 token: spesso meno di 1 GB in più;
- finestra da 8192: intorno a 1 GB;
- finestra da 32768: intorno a 4 GB.
Se nel motore attivi la compressione della cache, questi valori scendono. Valgono per i modelli recenti, che riusano le stesse tracce del testo già letto per più parti del calcolo (GQA, grouped-query attention). Un modello più vecchio tiene una traccia separata per ciascuna di quelle parti e può chiedere una cache fino a quattro volte più grande, a parità di finestra.
Su un 4B le stesse finestre pesano meno. Su un 70B pesano molto di più, perché la cache cresce anche con la dimensione del modello, non solo con il testo. Due persone con lo stesso file Q4 possono quindi vedere RAM diverse anche con una chat ancora corta: conta la finestra impostata, che viene riservata subito. I documenti allegati in TuaGPT riempiono quello spazio. Lo fanno crescere ancora solo se, per farli entrare, alzi la context length.
Solitamente i client per l'inferenza come anche TuaGPT, decidono quanta cronologia e quanti estratti di documenti mandare dentro quella finestra. Se la somma di istruzioni, messaggi precedenti, documenti e risposta prevista supera la context length, il motore taglia il testo oppure risponde con un errore. Aumentare il contesto nel motore risolve il taglio solo se la RAM regge la cache più grande.
Se compare un errore di memoria esaurita (OOM, out of memory), l'ordine utile è questo. Prima abbassa la context length: è memoria riservata, e la riduci senza cambiare modello. Poi riduci i messaggi di cronologia inviati al motore e la dimensione dei documenti in chat. Se ancora non basta, passa a una quantizzazione più compatta (da Q8 a Q5 o Q4) o a un modello con meno parametri. Alzare la finestra per far entrare il documento fa fallire di nuovo, se la RAM era già al limite.
Scheda video e RAM di sistema
La VRAM è la memoria sulla scheda video. Il modello è fatto di layer, strati impilati. L'opzione GPU offload dice quanti di quegli strati mettere sulla GPU. Più strati stanno in VRAM, più le risposte sono veloci, a patto che la VRAM li contenga.
Nel motore puoi scegliere quanti strati mettere sulla scheda. Se ne imposti troppi a mano, il caricamento fallisce: l'eccesso non finisce da solo nella RAM di sistema. In modalità automatica, LM Studio e programmi simili scelgono un numero di strati che entra in VRAM e lasciano il resto sulla CPU. Quella parte usa la RAM normale. La chat funziona, ma più lentamente.
I modelli vision (testo e immagini) portano in più una rete che legge le foto. Spesso quel pezzo non rientra nel numero di miliardi indicato per il modello di linguaggio. Un'immagine inviata in chat diventa a sua volta centinaia o migliaia di token, entra così nella finestra di contesto e nella KV cache.
Confronti che sembrano contraddittori
Il 4B occupa più dell'8B
Un 4B in FP16 tiene circa 8 GB di pesi. Un 8B in Q4 ne tiene circa 5. Il modello con meno parametri pesa di più, perché non è compresso e l'altro sì. Prima di confrontare due schede, leggi la sigla accanto alla B.
Il file è da 8 GB e la RAM va a 16
Se il file è un 4B in FP16, 8 GB su disco sono coerenti con 2 byte per parametro. Circa 16 GB di soli pesi in RAM sono coerenti con lo stesso modello tenuto in FP32, a 4 byte ciascuno. La finestra di contesto si somma a quella cifra, ma su un 4B da sola non spiega un altro raddoppio: a 8192 token aggiunge in genere meno di 1 GB. Guarda il formato del file e la context length prima di concludere che i modelli raddoppiano sempre.
Il file è da 4 GB e la RAM va a 8
Un file da circa 4 GB, per un modello da 4 miliardi, è tipicamente un Q8 (circa 4,3 GB), oppure un modello un po' più grande in Q4, per esempio un 7B. Un Q4 di un 4B è più vicino ai 2,5 GB. Se il processo arriva verso gli 8 GB, controlla la context length riservata e se la cifra che leggi è un picco durante il caricamento oppure il valore a regime. Il Q4, in llama.cpp e nei programmi che lo usano, resta compresso in memoria.
Lo stesso file, due PC, due consumi
Scheda video, numero di strati sulla GPU, context length e versione del motore cambiano l'occupazione. Quando un messaggio dice «questo 8B sta in 6 GB», di solito intende un Q4, una finestra intorno ai 4096 token e i pesi interamente su una GPU da 8 GB. Senza queste condizioni il numero non è confrontabile.
Modelli a esperti (MoE)
Alcuni modelli sono un insieme di reti specializzate, gli esperti (MoE, mixture of experts). Per ogni pezzo di testo ne usano solo alcuni. Il nome può citare i parametri totali, per esempio 30 miliardi, mentre il lavoro di un singolo token ne attiva molti meno, per esempio 3.
Il calcolo è più leggero. La memoria, spesso, no: tanti programmi caricano comunque tutti gli esperti. La RAM segue allora il totale, non la cifra «attiva». Solo alcuni motori sanno lasciare su disco gli esperti che in quel momento non servono. Se la scheda del modello distingue «parametri totali» e «parametri attivi», per la RAM parti dai totali, salvo che il programma dichiari di caricarne una parte.
Cosa decide TuaGPT
TuaGPT è il programma con cui scrivi. Invia messaggi, documenti e strumenti, e può limitare quanta cronologia mandare al server. La RAM del modello la occupa il motore che hai avviato: LM Studio, Ollama o un altro server compatibile con le API di OpenAI.
Per impostare contesto, quantizzazione e un profilo leggero c'è già la guida Best practice di configurazione, nella parte su LM Studio. Qui resta il criterio con cui scegliere il file:
- confronta Q4, Q5, Q8 e FP16 con la RAM e la VRAM che hai libere, non con il solo numero di miliardi;
- tieni la context length vicina all'uso reale: 4096 o 8192 per la chat breve, valori più alti solo se alleghi spesso documenti lunghi e la memoria lo consente;
- ricorda che l'archivio documenti (RAG) e i file contestuali riempiono la finestra. Se per farli entrare alzi la context length, sale anche la RAM riservata alla cache;
- se passi da TuaGate, il gateway inoltra la richiesta. I pesi restano nel motore collegato a TuaGate, in locale o nel cloud.
Domande frequenti
Più miliardi vuol dire risposte migliori?
Vuol dire più capacità potenziale e più memoria. Un 4B adatto al compito può bastare. Un 70B è spesso più solido sui ragionamenti difficili, e chiede un computer di un'altra categoria. A parità di miliardi, Q4, Q8 e FP16 sono tre file diversi dello stesso modello, non tre livelli di «intelligenza» scritti nel nome.
Un modello quantizzato è una copia non autorizzata?
No. È lo stesso modello riscritto con numeri più corti. Lo pubblicano gli autori oppure chi converte il file, quando la licenza lo permette. È il modo normale per eseguire questi modelli su un portatile o su un desktop.
Perché un servizio cloud non mi chiede la RAM?
Perché i pesi stanno sui server di chi offre il servizio. Con un modello locale stanno sul tuo PC. TuaGPT, in quel caso, è la finestra: la memoria la consuma il motore in ascolto.
Ho chiuso la chat ma la RAM è ancora occupata
Il modello resta caricato finché non lo scarichi dal motore. Chiudere la chat non basta. In LM Studio o in Ollama usa il comando di scaricamento del modello (in genere unload, scarica dalla memoria). Il processo del server, se lo lasci avviato senza modello, torna a occupare poco.
Cambia qualcosa se il modello si chiama Spark, Llama o Qwen?
Cambia l'addestramento e, un po', l'architettura. Per la memoria di un modello «denso» (tutti i parametri usati a ogni token, il caso più comune) contano i parametri, il formato del file e la context length. Due modelli da 4 miliardi in FP16 chiedono entrambi circa 8 GB di pesi. Due da 4 miliardi in Q4 stanno entrambi intorno ai 2,5 GB. Il marchio non aggiunge un raddoppio a parte.
Riepilogo
| Priorità | Cosa ricordare |
|---|---|
| Alta | I gigabyte dei pesi si stimano con: miliardi di parametri per byte di ciascun numero |
| Alta | Q4 sta intorno a 0,5 byte, Q8 a 1 byte, FP16 a 2 byte, FP32 a 4 byte |
| Alta | Un GGUF quantizzato, in LM Studio o Ollama, tiene i pesi circa alla dimensione del file |
| Alta | Il doppio rispetto al disco, sui pesi, capita se un FP16 viene tenuto in memoria come FP32. Il contesto si somma, e da solo non raddoppia un 4B |
| Media | La context length viene spesso riservata per intero all'avvio |
| Media | VRAM e RAM di sistema si sommano solo per le parti che stanno davvero in ciascuna |
| Bassa | Nei modelli a esperti, per la RAM guarda i parametri totali caricati, non solo quelli attivi a ogni token |
Per prevedere la RAM, servono tre dati insieme. Quanti parametri ha il modello. Quanti byte occupa ogni parametro nel file che hai scaricato. Quanta finestra di contesto il motore riserva mentre chatti. Con questi tre numeri, un 4B non quantizzato che occupa circa 8 GB di pesi, o circa 16 se il programma lo tiene in FP32, non è più una sorpresa. È il risultato del conto.
Commenti su «Quanta RAM serve a un modello LLM: parametri, quantizzazione e contesto»
Non ci sono ancora commenti. Scrivi il primo!
Lascia un commento
Non è necessario accedere. Commenti e risposte saranno pubblicati dopo approvazione. Puoi anche usare «Rispondi» sotto un commento già approvato.